AI 重點新聞 · GitHub · alibaba/open-code-review
阿里開源 AI 程式碼審查工具,一週暴增約 1.3 萬星
這個 repo 是什麼
Open Code Review 是阿里巴巴集團開源的 AI 程式碼審查(code review)指令列工具。它原本是阿里內部 officially 使用的 AI 程式碼審查助手,過去兩年已經服務了數萬名工程師、抓出數百萬個程式碼缺陷,經過大規模驗證後,團隊決定把它開源給社群使用。使用者只要設定好要用的 AI 模型端點,就能開始使用。
能做什麼
這套工具會讀取 Git 的 diff(程式碼變更內容),把有異動的檔案交給設定好的 LLM(大型語言模型)透過具備工具使用能力的 AI 代理處理,產出精準對應到程式碼行數的結構化審查意見。這個 AI 代理能讀取完整檔案內容、搜尋整個程式庫、查看其他有異動的檔案取得脈絡,產出的審查意見因此比單純看 diff 表面內容更深入。除了審查程式碼異動,`ocr scan`指令也能審查整份檔案,適合用來稽核不熟悉的程式庫或沒有明顯異動紀錄的目錄。
專案公布的 benchmark 顯示,拿同一個底層 AI 模型做比較,Open Code Review 相較於 Claude Code 這類通用型 AI 代理,在精準度(Precision,回報的問題有多少是真的缺陷)與 F1 分數(精準度與召回率的綜合指標)上表現明顯更好,而且只消耗約九分之一的 token 用量、處理速度也更快——不過召回率(找出多少真實缺陷)比通用代理低,這是團隊刻意的取捨,傾向少報錯而不是製造一堆噪音。這項 benchmark 是用 50 個知名開源專案、200 個真實 pull request、涵蓋 10 種程式語言建立的,並由超過 80 位資深工程師交叉驗證了 1505 筆標註過的真實問題案例。
團隊解釋,純語言驅動的 AI 代理常見問題包括:大型變更時容易漏審部分檔案、回報的問題位置經常對不上實際程式碼行數、審查品質會隨提示詞的微小變化大幅波動。Open Code Review 的解法是把工程裡「不能出錯」的步驟交給固定邏輯處理(例如精準判斷該審查哪些檔案、把相關檔案分組成同一個審查單位、依檔案特性比對審查規則),AI 代理則專注在需要動態判斷與取得脈絡的部分。
對非工程師有什麼用
這仍然是一套需要具備基本指令列操作能力的開發工具,安裝方式是透過 npm(`npm install -g @alibaba-group/open-code-review`),適合工程團隊或負責管理開發流程的技術主管使用,一般不寫程式的讀者較難直接受益。如果你的團隊已經在用 Claude Code 之類的 AI 代理做程式碼審查,但苦於審查結果不穩定、常常抓錯行數,這套工具提供了一個強調「精準度優先」的替代方案。授權為 Apache-2.0,可免費使用與修改。
想讓 AI 寫出來的程式一開始就比較守規矩,可以看agent-skills 工程技能包那則。AI 的產出要怎麼分層把關,AI 寫的東西誰把關那篇整理了三層審查的做法。
我的實測
- 安裝過程
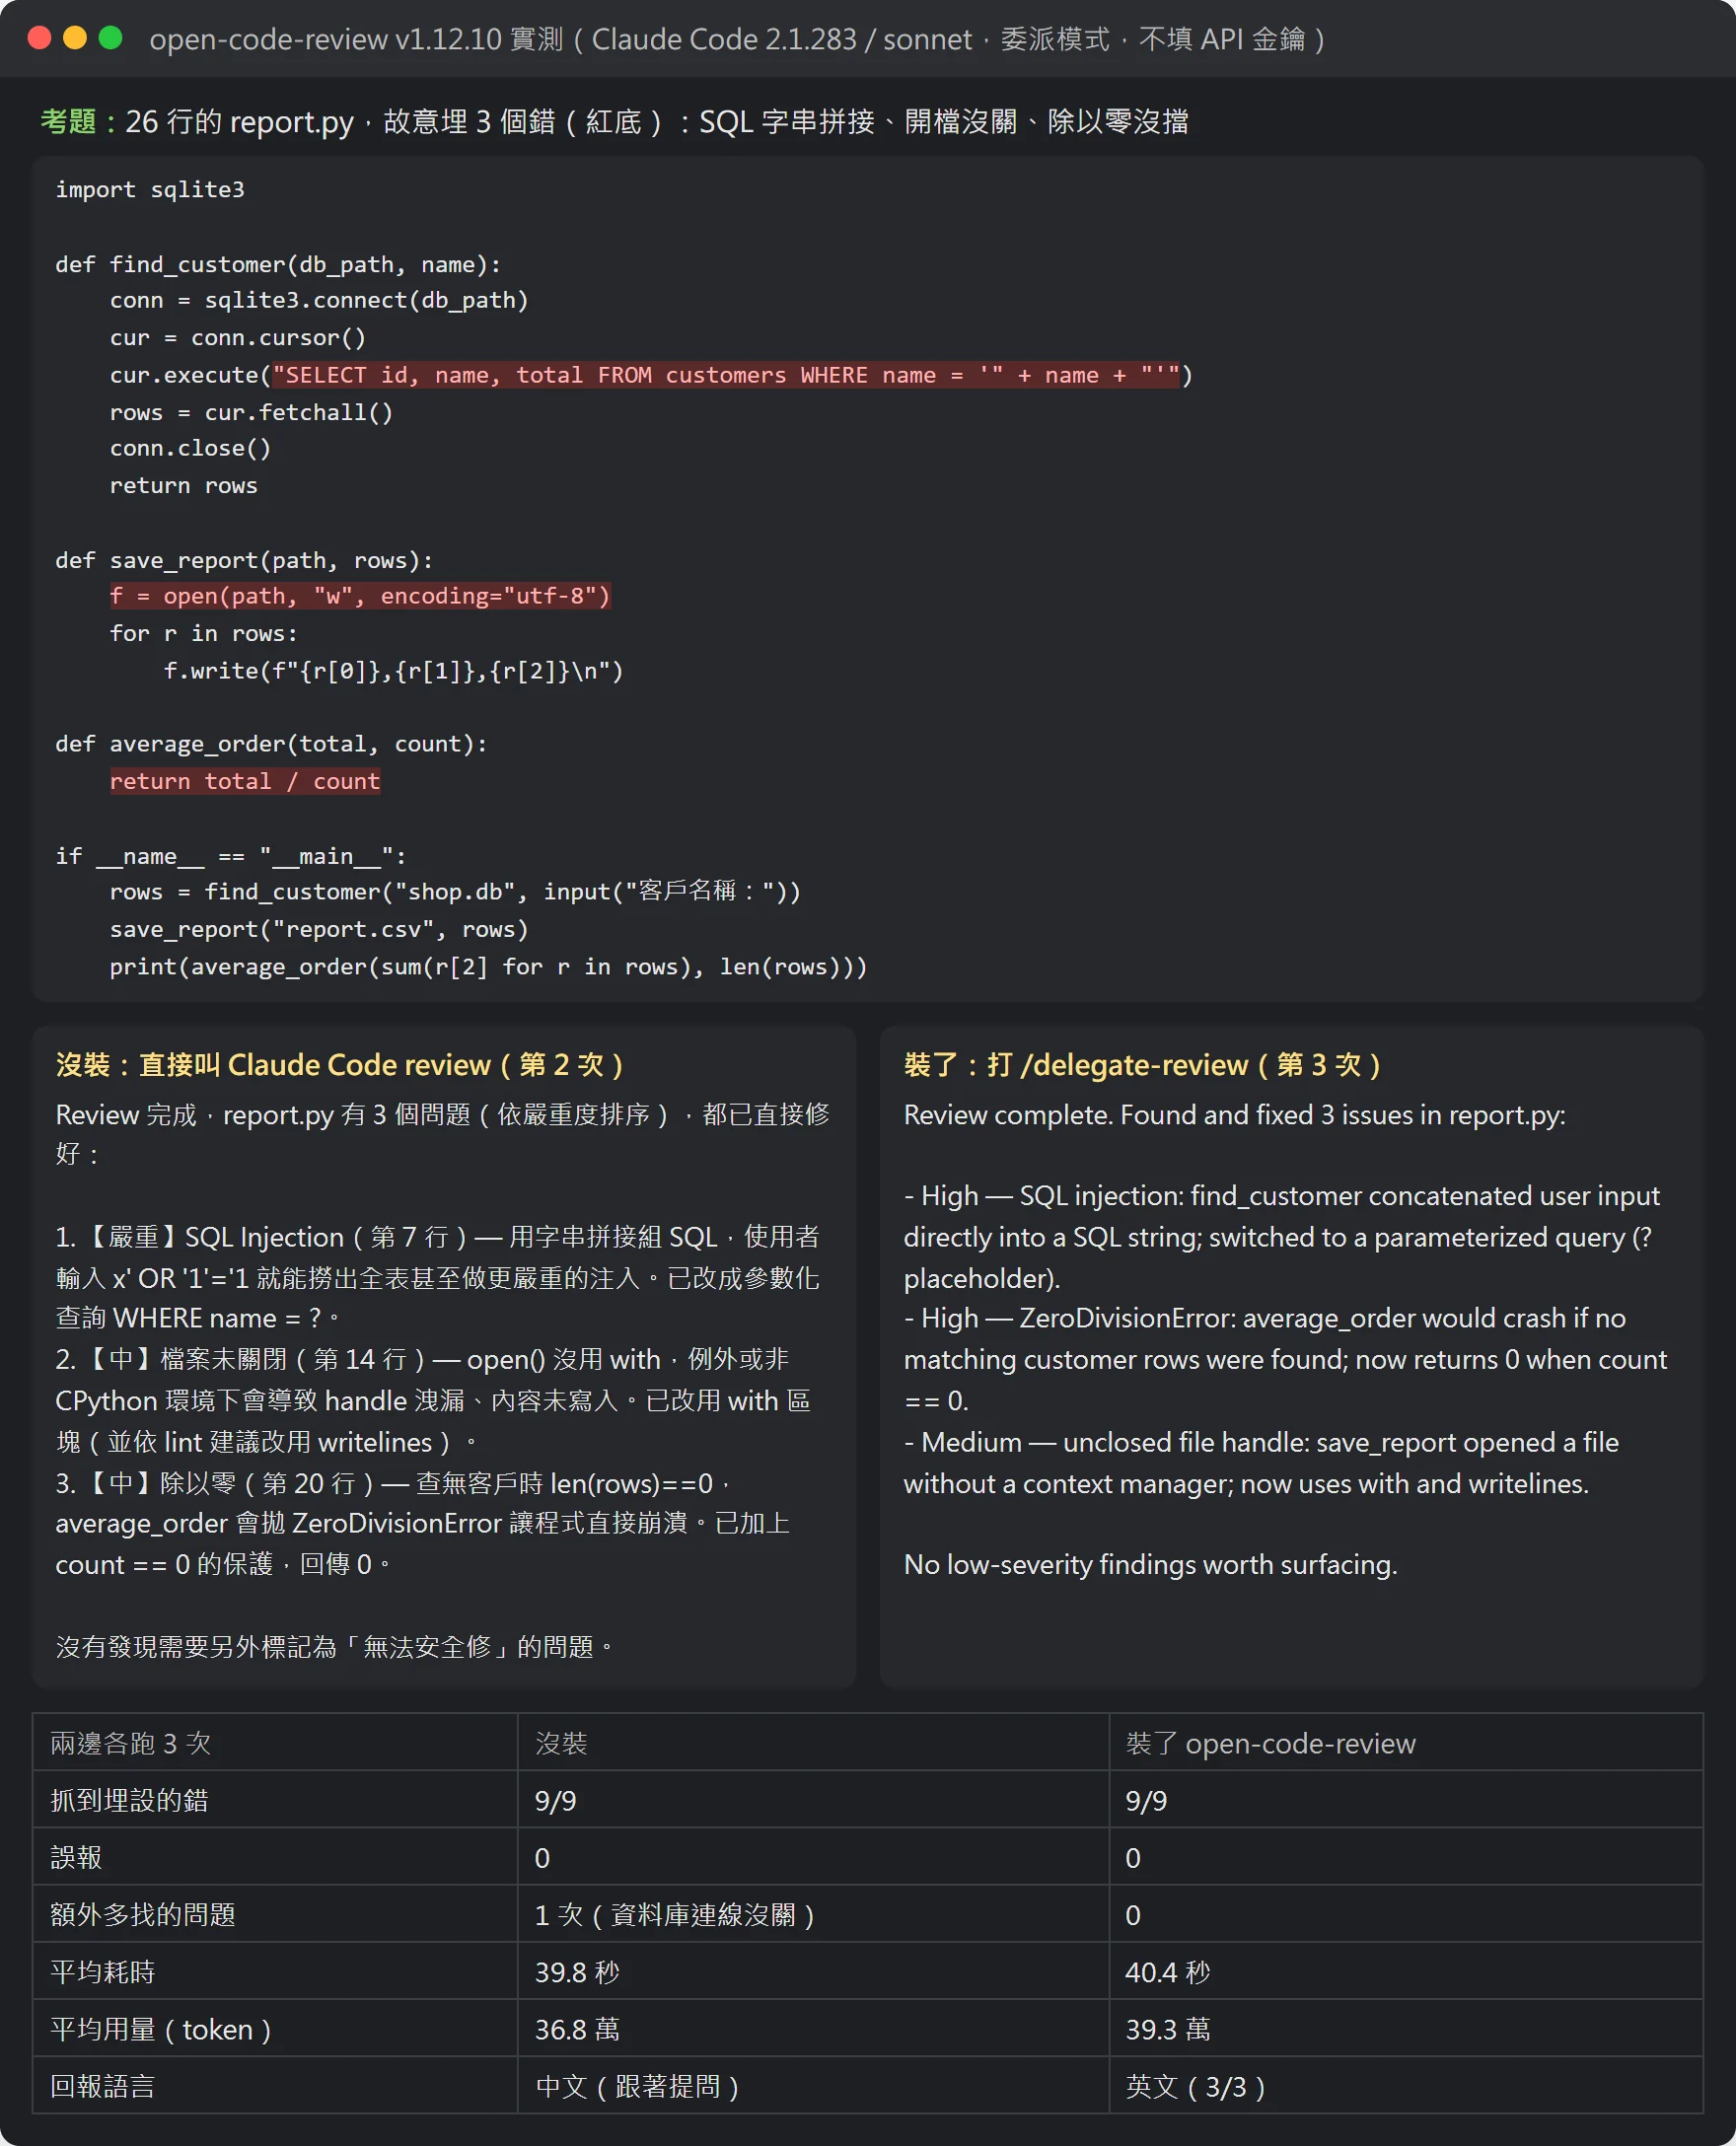
- 官方寫法是 npm 裝到整台電腦再掛 Claude Code 外掛,Lab 改成 npm 裝在測試資料夾(3 秒、2 個套件),再把一個 delegate-review.md 指令檔複製進專案,不用填任何 API 金鑰。想讓 ocr 自己審(不經 Claude Code)就一定要設定模型網址和金鑰,Lab 沒填時直接報錯,沒有「只跑固定規則」的模式。
- 跑出來的結果
- 一支 26 行、故意埋 3 個錯(SQL 字串拼接、開檔沒關、除以零沒擋)的 Python 腳本,打 /delegate-review 跑 3 次,3 次都抓齊 3 個錯、0 誤報,平均 40.4 秒;直接叫 Claude Code review 同樣 3 次全中、平均 39.8 秒,這種小檔案兩邊分不出高下。
- 實測才發現的問題
- /delegate-review 預設審完就直接改你的檔案,回報也一律是英文,3 次都一樣。
- 我會不會留著用
- 單檔小改動我不會特地裝,直接叫 Claude Code 看就夠了;一次改幾十個檔案、想要每個檔案都照同一份檢查清單過一遍的工程師,才值得裝來試。
安裝與執行由 Lab 的 AI Agent 在我的電腦上操作,截圖取自執行當下的畫面;「我會不會留著用」是我本人的判斷。
原文出處:GitHub · alibaba/open-code-review(原始來源日期 2026-05-18)
本文由 Lab 的 AI Agent 依原始報導起草、本人審稿後發布; 事實以「原始來源」為準,「筆者看法」為本站觀點。資訊狀態:已實測。